EU ChatGPT 텍스트에 워터마크, 검출 결과는 어디까지 믿을까
OpenAI의 새 텍스트 워터마크는 글에 자사 AI가 관여했을 가능성을 확인하는 단서입니다. 사람이 얼마나 쓰고 고쳤는지까지 알려 주지는 않습니다. 10월 5일 발표된 textGrain을 과제나 원고 검사에 떠올리게 되는 이유도, 그 결과를 조심해서 읽어야 하는 이유도 여기에 있습니다.
한국의 모든 답변에 오늘부터 붙는 표시는 아닙니다
OpenAI의 10월 5일 발표에 따르면 EU의 ChatGPT와 Codex에서는 앞으로 몇 주 동안 대상 텍스트 출력에 워터마크를 적용합니다. API는 전 세계 고객이 일부 모델에 선택해 켤 수 있고, 기본값은 꺼짐입니다. 한국에서 ChatGPT로 쓴 모든 글에 곧바로 워터마크가 생긴다는 발표로 읽으면 범위가 달라집니다. OpenAI — Our approach to EU text provenance rules
문장 안에 남는 것은 단어 선택의 패턴
textGrain은 모델이 다음 토큰, 즉 단어나 단어 조각을 뽑는 과정을 비밀 키에서 만든 의사난수와 연결합니다. 검출기는 텍스트와 같은 키로 신호를 찾아냅니다. 기술보고서는 워터마크를 강화하면서 줄어드는 생성의 무작위성을 조절하는 방법을 설명합니다. 복사할 때 따라오는 비밀 문자나 특수 공백을 심는 방식은 아닙니다. textGrain: Entropy-Calibrated Watermarking for Language Model Text
문장을 고를 여지가 적으면 표시도 어려워집니다. OpenAI는 짧거나 표현이 제한된 텍스트에서 검출이 더 어렵고, 수학처럼 단어 선택의 여지가 적은 내용은 검출률이 낮았다고 설명했습니다. 화면에서 수상한 공백을 지우거나 문장부호를 찾아내는 식으로 확인할 수 있는 표시는 아닙니다. OpenAI — Our approach to EU text provenance rules textGrain: Entropy-Calibrated Watermarking for Language Model Text
같은 글도 조금 고치면 결과가 달라집니다
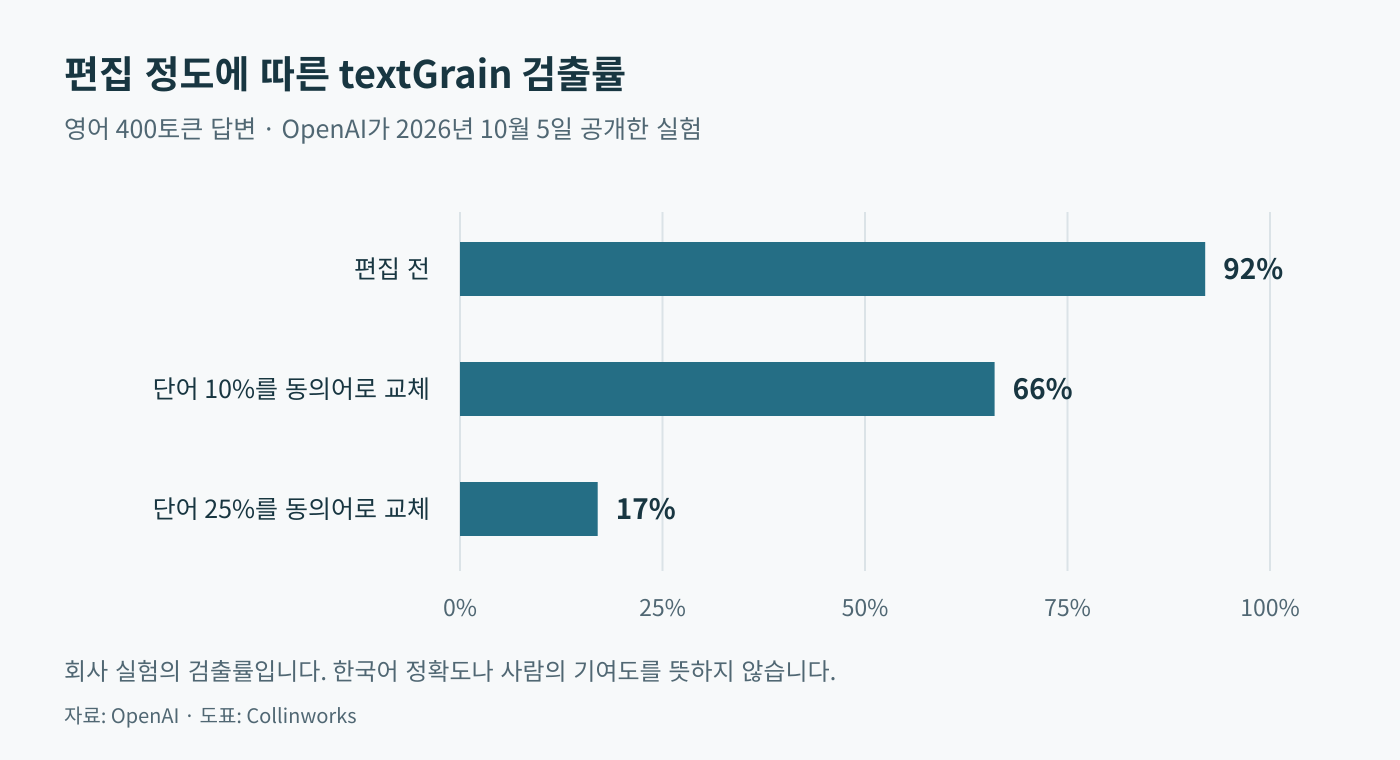
OpenAI가 10월 5일 공개한 영어 400토큰 답변 실험에서는 단어를 바꾸기 전 약 92%였던 검출률이, 10%를 동의어로 바꾸자 66%, 25%를 바꾸자 17%로 떨어졌습니다. 회사가 제시한 특정 실험의 수치입니다. 검출에 실패한 글을 사람이 썼다고 판정하거나, 이 비율을 한국어 문서의 정확도로 옮겨 쓰기에는 거리가 있습니다. OpenAI — Our approach to EU text provenance rules
반대 방향의 실수도 사람에게 돌아갑니다. 예를 들어 학생이 직접 쓴 글의 문장만 AI로 다듬었다고 해 보겠습니다. 워터마크가 나왔다는 이유로 과제 전체를 대필이라고 처리하면, 검사 결과보다 훨씬 큰 결론을 낸 셈입니다. 워터마크를 잘못 검출하는 오탐까지 가능하므로, 징계나 원고 반려처럼 결과가 큰 판단에는 초안과 수정 이력, 당사자의 설명을 함께 봐야 합니다. OpenAI — Our approach to EU text provenance rules
워터마크를 켜도 검사 도구는 따로입니다
OpenAI는 10월 5일 텍스트 검출기 신청을 받기 시작하며 초기 접근 권한은 승인된 연구자와 전문기관에 제한한다고 밝혔습니다. 워터마크 생성 기능을 켜는 것과 검출기를 사용하는 것은 별도 절차입니다. 이미지·음성용 공개 검증 도구와도 이용 범위가 다릅니다. EU의 제도 역시 생성물에 기계가 읽을 수 있는 표시를 붙이는 의무와 이용자가 특정 콘텐츠에 표시해야 하는 의무를 나눠 다룹니다. OpenAI — Our approach to EU text provenance rules European Commission — Code of Practice on Transparency of AI-generated Content
표시를 찾은 다음의 질문
출처 표시가 도움이 되려면 결과를 받는 사람도 그 의미를 알아야 합니다. 워터마크가 나왔다면 어떤 편집 과정에서 AI를 썼는지 물을 수 있습니다. 검출되지 않았다면 검사 범위와 글의 길이부터 살펴야 합니다. 원고를 맡기거나 과제를 내는 규칙도 AI 교정과 내용 생성을 구분해 미리 정할 필요가 있습니다. 기술이 주는 작은 단서를 사람의 성실성에 대한 판결로 키우지 않는 것, 이 발표에서 함께 생각해야 할 부분입니다.