문서에 답이 없을 때 멈추도록 가르친 AI, Kolibri
독일 Aleph Alpha가 10월 3일 공개한 Kolibri는 문서의 핵심 근거를 가려 놓고도 답하려 하는지 점검하며 훈련한 AI 모델입니다. 근거가 충분할 때는 답하고 부족할 때는 유보하도록 가르쳤습니다. 회사 규정이나 계약서를 읽는 AI라면, 빈칸을 그럴듯한 말로 채우지 않는 능력도 중요합니다.
규정집을 줬는데도 답을 다시 확인해야 한다면
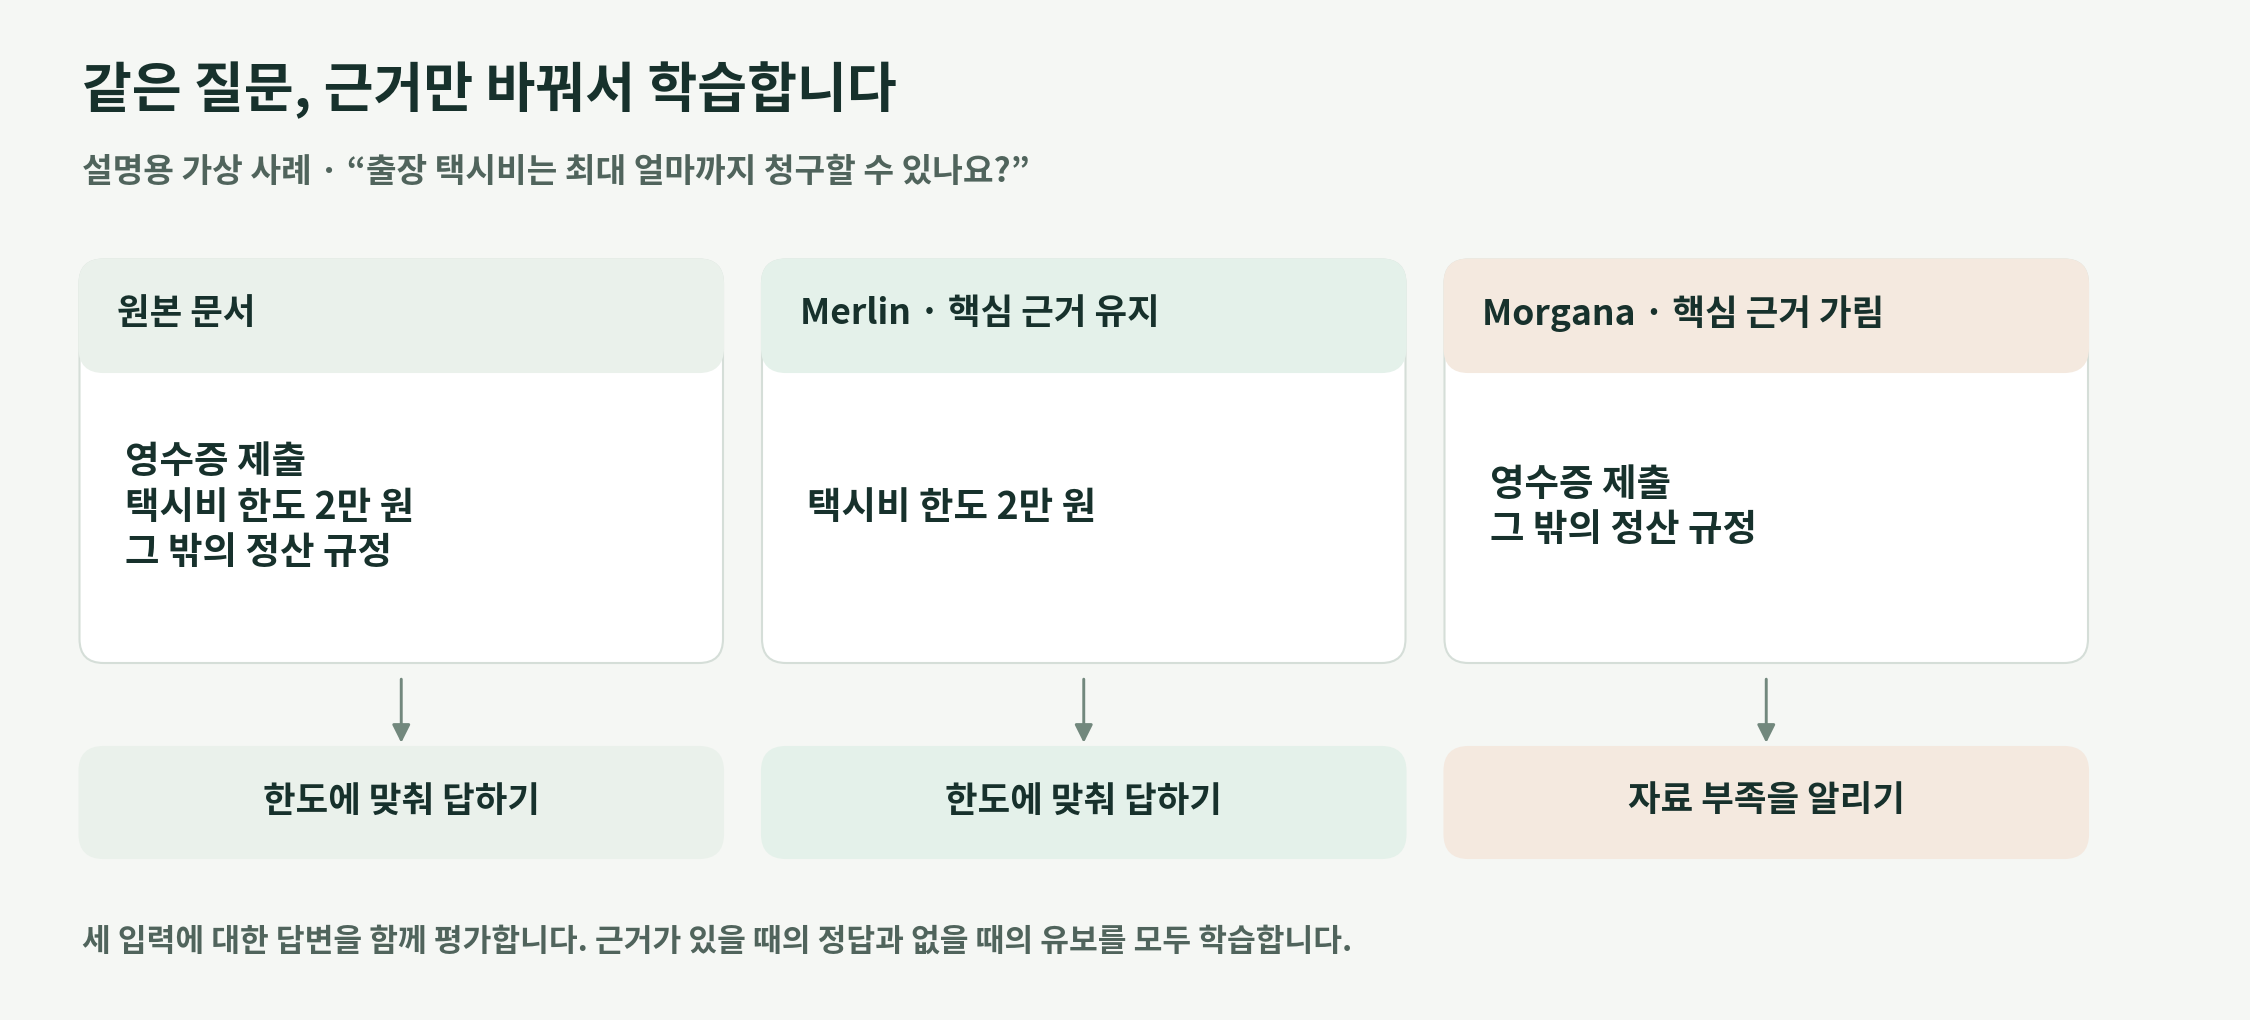
출장비 규정에서 “교통비는 영수증을 제출한다”는 문장만 검색됐다고 가정해 보겠습니다. 여기서 택시비를 얼마까지 청구할 수 있는지 물으면 한도 조항을 더 찾아야 합니다. 일반적인 회사 관행을 끌어와 금액을 답하면 그럴듯해도 우리 회사의 답은 아닙니다. 문서 검색을 붙인 AI, 흔히 RAG라고 부르는 방식의 쓸모는 이런 내부 기준을 찾는 데 있습니다. 답의 근거가 빠졌다는 사실도 알려 줘야 사람이 필요한 조항을 보완할 수 있습니다.
근거를 가려 놓고도 대답하는지 봅니다
Aleph Alpha의 Merlin–Arthur 방식은 같은 질문에 서로 다른 근거를 줍니다. Merlin은 답을 뒷받침하는 부분을 남기고, Morgana는 결정적인 부분을 가려 그럴듯한 주변 문장만 남깁니다. 실제 답변 모델인 Arthur는 어느 쪽 문서를 받았는지 모릅니다. 근거가 있으면 답하고, 부족하면 유보해야 좋은 점수를 받습니다. 질문마다 답할 수 없는 예시를 사람이 새로 쓰는 부담을 줄이려는 접근입니다. Aleph Alpha — Bounding Hallucinations: Merlin-Arthur Protocols for Mutual-Information Bounds in Language Models
가령 앞의 출장비 예시에서 금액 조항을 읽을 수 있을 때는 한도를 맞혀야 합니다. 그 조항을 가렸을 때는 추가 자료가 필요하다고 해야 합니다. 두 경우에 똑같이 확신하는 모델을 찾아낼 수 있습니다. 출처 문장을 붙이는 것만으로는 해결되지 않는 이유도 드러납니다. “영수증을 제출한다”는 문장을 정확히 인용해 놓고도, 그 문장에 없는 금액을 덧붙일 수 있기 때문입니다. 이 예시는 학습 방식의 차이를 설명하기 위해 구성했습니다. Aleph Alpha — Bounding Hallucinations: Merlin-Arthur Protocols for Mutual-Information Bounds in Language Models
멈추는 능력은 얼마나 좋아졌을까요
10월 3일 공개 자료에 연결된 Kolibri 기술보고서의 RGB 평가에서, 답이 들어 있지 않은 문서를 보고 답변을 유보한 비율은 Kolibri 85.6%, 앞선 내부 모델 Kolibri Origin 73.9%입니다. 회사가 측정한 같은 항목에서 11.7%포인트 높아졌습니다. 다만 이는 답 없는 문서에 대한 시험 결과입니다. 실제 업무의 모든 답변 중 85.6%가 정확하다거나, 나머지를 곧바로 환각 비율이라고 읽을 수는 없습니다. Kolibri: A Sovereign European Model on the Pareto Frontier — Technical report
새 모델이 무조건 더 안전하다고 결론 내리기에도 평가 범위가 남아 있습니다. 같은 보고서에서 Kolibri의 답변 유보 점수보다 높은 비교 모델도 있고, 문서 없이 답하는 RGB 항목은 Kolibri Origin보다 낮았습니다. 잘 멈추는지와 필요한 답을 놓치지 않는지를 같이 봐야 한다는 뜻입니다. 보고서도 그 두 능력을 서로 다른 시험으로 측정합니다. Kolibri: A Sovereign European Model on the Pareto Frontier — Technical report
한국어 회사 문서에는 별도의 시험이 필요합니다
10월 6일 확인한 모델카드의 중심 언어는 독일어와 영어입니다. 전체 매개변수는 약 781억 개이고 토큰마다 약 34.6억 개를 사용하지만, 공식 FP8 가중치의 메모리 규모는 약 78GB입니다. 문맥 길이는 최대 1,048,576토큰을 지원하되 복잡한 작업과 운영 효율에는 262,144토큰 이하를 권합니다. 가중치를 받아 직접 운영할 수 있다는 점과 한국어 사내 시스템에 바로 맞는다는 판단 사이에는 언어·장비·문서별 검증이 필요합니다. Aleph-Alpha/Kolibri-1 — Official model card
우리 규정에서 한 문장을 빼 보면 됩니다
업무용 AI를 고를 때는 정답이 있는 질문에 더해, 정답을 정하는 문장만 빠진 질문도 준비해 볼 만합니다. 원문에서는 답을 맞히고, 빠진 문서에서는 부족한 근거를 짚는지 비교하는 겁니다. 매번 모른다고만 하면 일을 맡기기 어렵고, 매번 답하면 틀린 확신을 걸러야 합니다. 원문과 핵심 근거를 가린 문서 양쪽에서 확인해야 하는 이유입니다. 필요한 답은 빠뜨리지 않고, 자료가 부족한 질문은 골라서 돌려줘야 실제로 사람의 검토 부담이 줄어듭니다.