
딥시크 1017의 성능 향상, 점수보다 비교 조건부터 봐야 한다
딥시크 V4.1-Flash-1017은 성능 개선을 주장할 만한 공식 점수를 제시했다. 다만 그 차이 전부가 모델 자체의 향상인지 판단하려면 이전 버전을 같은 도구와 설정으로 다시 시험했는지까지 확인해야 한다.
이 글에서
01 점수는 올랐다 무엇을 함께 바꿨는지도 봐야 한다02 개인 실험은 도움이 되지만, 검증의 범위가 다르다03 검색 API 공개와 Codex 내장 검색은 별개다04 도입 판단은 성공한 작업 하나의 비용 으로05 출처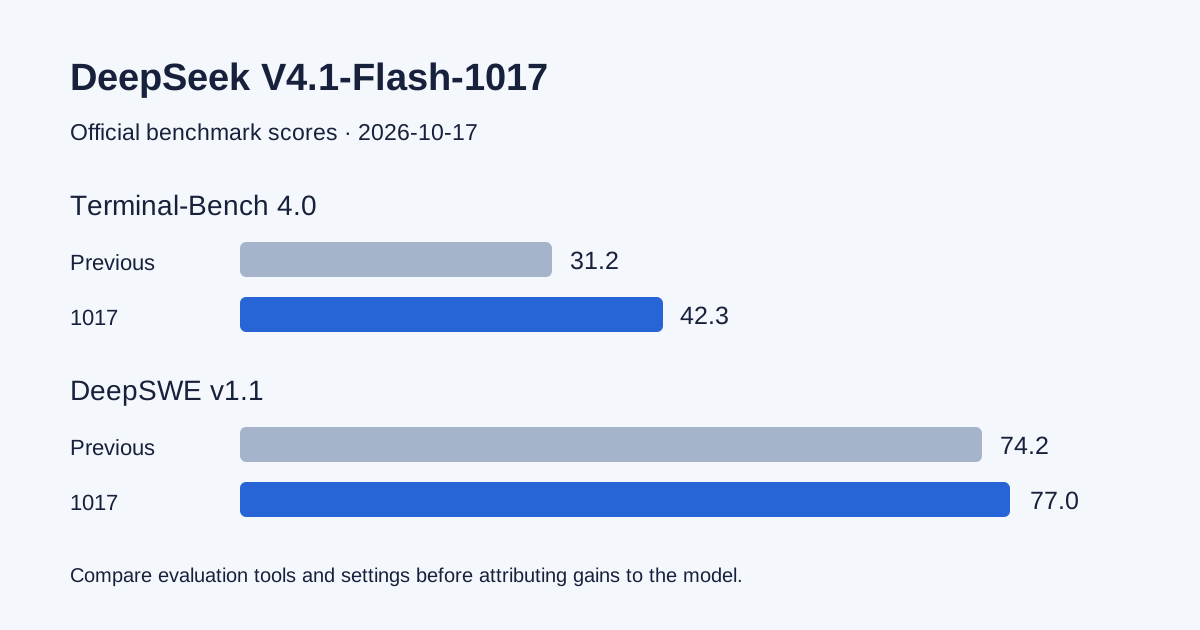
DeepSeek는 2026년 10월 17일 웹·앱·API를 새 모델로 갱신했다. API 이름은 deepseek-flash로 유지되며, 호출 방법과 모델 요금도 그대로다. 이용자는 같은 이름을 호출하면서 새 버전을 쓰게 된다.[1] 회사는 이번 업데이트에 프로젝트 작업을 위한 자기 피드백 강화학습을 적용했다고 설명한다.[2] 눈여겨볼 부분은 그 설명이 실제 작업 결과로 얼마나 이어지는가다.
점수는 올랐다. 무엇을 함께 바꿨는지도 봐야 한다
DeepSeek의 10월 17일 새 모델 카드에서 Terminal-Bench 4.0은 이전 31.2에서 42.3으로, DeepSWE v1.1은 74.2에서 77.0으로 표시된다. 각각 11.1점과 2.8점 차이다. 공식 표에서 새 모델은 DeepSWE의 Opus 5 점수 74.0보다 높지만, Terminal-Bench 4.0에서는 Opus 5의 51.8보다 낮다. 특정 평가의 우위를 코딩 전체의 우위로 넓히면 표가 말하는 범위를 벗어난다.[3]
더 중요한 부분은 표 아래의 조건이다. 이전 모델 카드는 Terminal-Bench 평가에 DeepSeek Harness의 Minimal 모드를 사용했다고 설명한다. 새 모델 카드는 Terminal-Bench 4.0에 Claude Code를 사용했다고 적었다.[3][4]
이런 실행 도구는 모델이 파일을 읽고, 명령을 실행하고, 결과를 받아 다음 행동을 고르는 방식을 구성한다. 같은 모델도 도구가 주는 지시와 작업 흐름에 따라 결과가 달라질 수 있다. 따라서 두 문서에 서로 다른 도구가 적혀 있다면, 숫자 차이를 모델만 바꾼 실험의 결과로 곧바로 읽기는 어렵다.
그렇다고 비교가 잘못됐다고 단정할 근거도 없다. 새 표를 만들면서 이전 모델까지 같은 환경에서 재평가했을 가능성과, 종전 점수를 사용했을 가능성을 구분해야 한다. 공개된 설명만으로는 어느 쪽인지 확정하기 어렵다. 필요한 것은 의혹을 키우는 표현보다 이전·새 모델의 실행 조건을 나란히 확인할 수 있는 기록이다.
기준 점수도 한 번 더 확인할 이유가 있다. 10월 18일 확인한 이전 모델 카드에는 NL2Repo-Bench가 64.0으로, 새 카드의 이전 모델 비교 열에는 65.4로 적혀 있다. 새 모델 점수는 68.2다.[3][4] 재평가나 정정 때문인지는 해당 표에서 설명하지 않는다. 이 항목의 상승 폭을 강조하기 전에 기준값이 달라진 이유부터 확인하는 편이 타당하다.
개인 실험은 도움이 되지만, 검증의 범위가 다르다
외부 사용자가 공개한 결과도 있다. 개발자 Ibragim Badertdinov의 개인 코딩 평가 페이지는 일상 개발에서 가져온 10개 과제를 각 세 번 실행한다. 10월 17일 갱신된 표에서 1017 모델은 Pi·high 설정으로 30회 모두 성공했고, 평균 시간은 2분 38초, 과제당 비용은 0.0450달러로 제시됐다. 이전 모델은 Pi·max 설정에서 성공률 93.3%, 4분 30초, 0.0425달러였다.[5]
이 결과는 그 사람이 고른 작업에서 새 모델이 어떻게 움직였는지 보여준다. 다만 추론 설정이 high와 max로 다르고 과제도 10개다. 공식 Terminal-Bench를 독립적으로 재현한 결과도 아니다. 새 모델이 더 빨랐다는 관찰은 참고할 수 있지만, 일반적인 성능 향상률로 확대할 수는 없다. 비용 역시 이 표에서는 새 모델이 조금 더 높다.
실제로 쓸 사람에게 필요한 비교는 오히려 단순하다. 같은 저장소 상태에서 같은 요청을 주고, 같은 실행 도구와 시간·토큰 한도를 적용한다. 한 번 잘 나온 답보다 반복 실행한 성공률을 보고, 테스트 통과 여부와 수정한 코드의 적절성을 확인한다. 시간과 비용은 실패 후 재시도까지 포함해 기록해야 한다. 이 글에서 직접 그런 실험을 수행한 것은 아니다. 도입 여부를 판단할 때 적용할 기준이다.
검색 API 공개와 Codex 내장 검색은 별개다
DeepSeek는 모델 업데이트와 같은 날 Search·Fetch API도 공개했다.[1] Search는 웹 검색 결과를, Fetch는 지정한 페이지의 내용을 가져오는 별도 기능이다. DeepSeek의 Codex 연동 문서는 내장 웹 검색을 deepseek-v4-pro에서만 지원한다고 안내한다.[6] Flash 모델을 Codex에 연결할 수 있다는 설명을 Flash에서도 내장 검색이 그대로 된다는 뜻으로 읽으면 안 된다.
비용도 나눠 봐야 한다. 10월 18일 확인한 공식 요금은 Search와 Fetch 각각 성공 요청 1,000회당 0.75달러다. 가령 작업 1,000건에서 매번 검색 한 번과 페이지 가져오기 다섯 번을 실제로 성공시킨다면, 6,000회의 도구 요청에 4.50달러가 든다. 모델 토큰 요금은 별도다.[7]
이 계산은 호출 횟수를 가정한 예시다. 검색 결과 다섯 개를 받는 것만으로 Fetch 다섯 건이 자동 과금된다는 뜻은 아니다. 공식 문서는 검색 결과 개수가 요청당 가격을 바꾸지 않는다고 명시한다. 지정된 에이전트 경로의 서버측 도구 호출은 현재 무료이며, 해당 호출의 과금은 한국시간 11월 1일 오전 1시부터 시작한다고 안내한다. 직접 호출하는 Search·Fetch 전체에 적용되는 무료 기간으로 확대해서는 안 된다.[7]
도입 판단은 ‘성공한 작업 하나의 비용’으로
이번 업데이트는 시험해 볼 이유가 있다. 기존 호출 방식을 유지하면서 개선된 모델을 제공하고, 공식 점수와 외부의 작은 실험 모두 살펴볼 재료를 더했다. 다만 순위표 하나만 보고 기존 도구를 대체할 단계라고 결론 내리기는 이르다.
실용적인 판단 기준은 성공한 작업 하나에 들어간 시간과 총비용이다. 값싼 모델도 여러 번 실패하면 비용이 커지고, 높은 점수도 쓰는 환경에서 재현되지 않으면 효용이 줄어든다. 이번 딥시크 발표에서 더 보고 싶은 것은 순위의 크기보다 비교 조건의 선명함이다. 같은 조건에서 얼마나 안정적으로 끝내는지가 드러나야, 개선이라는 말이 실제 선택의 근거가 된다.
출처
- [1] DeepSeek, Change Log, 2026-10-17 항목. 발표 날짜, 웹·앱·API 갱신, 호출 이름·모델 요금 유지, 검색 API 공개.
- [2] DeepSeek, DeepSeek-V4.1-Flash-1017: Wish-Driven Programming Made Real, 2026-10-17 발표. 학습 방식과 프로젝트 작업 개선에 대한 회사 설명.
- [3] DeepSeek 공식 새 모델 카드, 2026-10-18 확인. 공식 비교표와 평가 도구 주석. 회사 자체 평가로 읽었다.
- [4] DeepSeek 공식 이전 모델 카드, 2026-10-18 확인. Instruct Model 평가 조건, Terminal-Bench 도구, NL2Repo 기준 점수 대조.
- [5] Ibragim Badertdinov, Personal Coding Evals, 페이지 갱신일 2026-10-17. 10개 과제·각 3회인 개인 평가. 공식 벤치마크 재현이나 일반 순위로 취급하지 않았다.
- [6] DeepSeek, Integrate with Codex, Web Search 항목, 2026-10-18 확인. 내장 검색의 모델 지원 범위.
- [7] DeepSeek, Search & Fetch, Billing 항목, 2026-10-18 확인. 성공 요청 기준, Search·Fetch 개별 요금, 한시 무료 적용 범위 및 과금 시점. 4.50달러는 공개 단가에 가정한 호출 수를 곱한 자체 계산.
- [8] 竹元かつみ, PC Watch, コード系でOpus 5超え「DeepSeek-V4.1-Flash-1017」無償公開, 2026-10-17 22:29 JST 보도. 보도 시각 확인용이며 성능 판단은 공식 표 원문을 기준으로 했다.