기억나는 장면으로 내 자료를 찾는 AI, EmbeddingGemma 2
EmbeddingGemma 2는 파일명을 몰라도 사진·영상·녹음을 기억나는 내용으로 찾는 기능을 기기 안에서 만들 수 있게 해줍니다. Google이 2026년 10월 6일 공개한 이 모델은 서로 다른 형식의 자료를 같은 검색 공간으로 연결합니다. 개인 자료를 서버에 보내지 않고도 어디까지 찾을 수 있을까. 발표를 읽으며 따라가 볼 질문은 여기에 있습니다.
기억에는 장면이 남고 폴더에는 파일명이 남습니다
가령 “비 오는 골목에서 간판을 찍었던 영상”을 찾는다고 해보겠습니다. 찍은 날짜가 가물가물하고 파일명도 자동으로 붙어 있다면 폴더를 열어 하나씩 재생하게 됩니다. 메모도 마찬가지입니다. 어떤 문제를 해결하는 내용인지는 기억나는데, 당시 어떤 단어로 적었는지는 생각나지 않을 수 있습니다. 자료를 많이 모으는 것과 필요할 때 꺼내 쓰는 것 사이에는 이런 간격이 있습니다.
임베딩은 이 간격을 줄이는 방법입니다. 검색어와 자료의 특징을 숫자 묶음으로 바꾸고, 숫자 사이의 유사도를 비교해 후보를 고릅니다. Google의 2026년 10월 6일 개발자 안내에 따르면 EmbeddingGemma 2는 글·코드·이미지·영상·오디오를 공통의 768차원 공간으로 표현합니다. Google Developers Blog 자료 5 “비 오는 골목”이라는 글과 해당 장면이 담긴 영상을 같은 기준으로 비교할 수 있는 구조입니다.
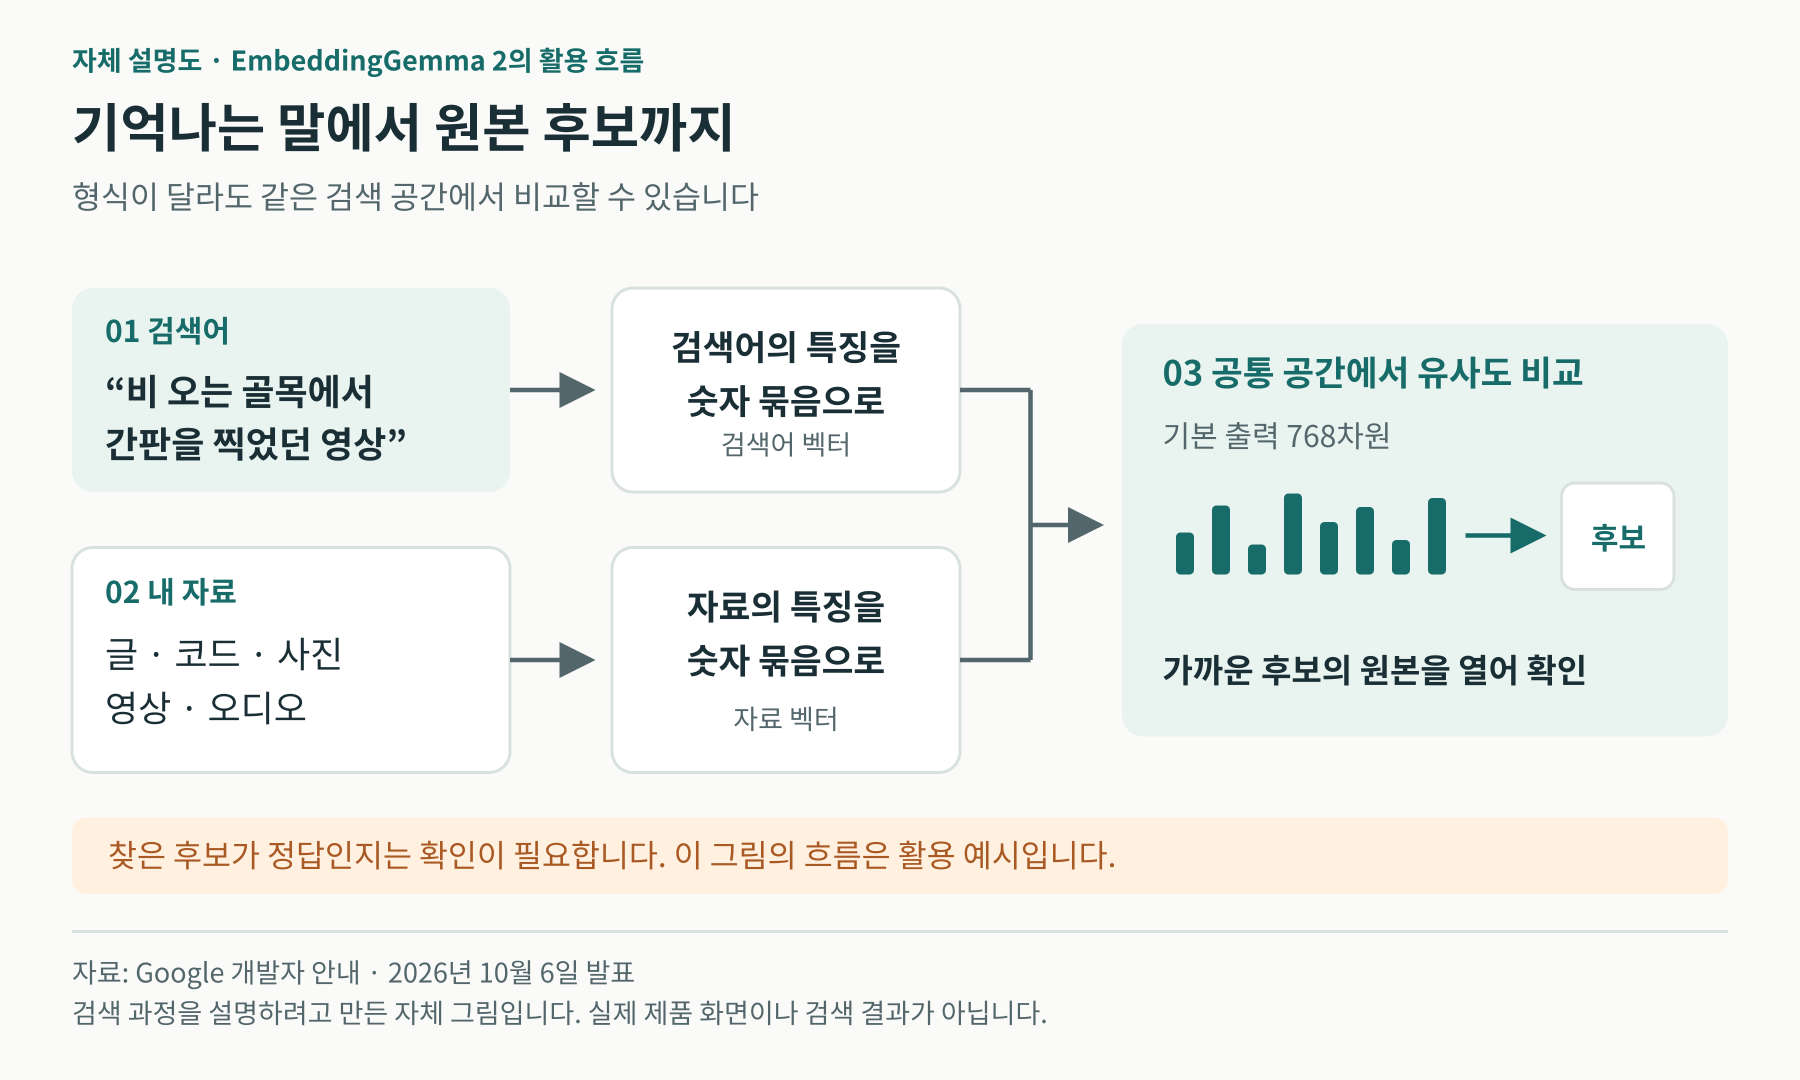
서로 다른 형식의 자료가 같은 검색 공간에 놓인다는 점이 흥미롭습니다. 어떤 내용을 글로 적었는지, 사진으로 찍었는지부터 떠올릴 필요가 줄어들기 때문입니다. 이를테면 작업 방법을 기록한 자료를 찾을 때 메모와 설명 사진을 함께 후보로 받을 수 있습니다. 형식별로 앱을 열어 같은 말을 반복 검색하는 수고를 덜 여지가 생깁니다.
찾은 자료를 어떻게 보여줄지는 그다음 설계입니다. 원본 파일과 영상 시점을 제시할 수도 있고, 검색 결과를 생성형 모델에 넘겨 답을 쓰게 할 수도 있습니다. Google도 의미 검색과 검색 증강 생성(RAG)을 활용처로 구분합니다. Google AI for Developers 자료 3 처음부터 모든 자료를 대신 읽고 설명하는 비서를 만들 필요는 없습니다. 기억나는 말로 검색하고, 맞는 원본을 바로 여는 도구만으로도 쓸모가 분명합니다.
사진을 찾는 앱에 모든 기능을 실을 필요는 없습니다
개인 기기에서 이 기능을 만들려면 먼저 모델을 띄울 자리가 있어야 합니다. Google의 2026년 10월 6일 개발자 안내에서 EmbeddingGemma 2의 전체 매개변수는 7억 4,000만 개지만, 텍스트·코드만 처리할 때는 2억 7,000만 개, 텍스트와 비전을 함께 쓸 때는 4억 4,000만 개 구성을 선택할 수 있습니다. Google Developers Blog 자료 5 사진 검색부터 시작하는 앱이라면 사용하지 않는 오디오 인코더를 메모리에 올리지 않아도 됩니다.
Google의 2026년 10월 6일 발표에서 Pixel 11 Pro로 측정한 양자화 모델의 활성 RAM은 텍스트 전용 가중치 약 191MB, 전체 멀티모달 모델 약 567MB입니다. Google The Keyword 자료 1 모델을 개인 기기에서 실행할 가능성을 보여주는 수치입니다. 실제 검색 앱에는 파일을 읽고 처리하는 메모리, 검색 색인, 화면을 띄우는 비용도 더해집니다. 기기 전체가 이 용량만 쓰거나 다른 휴대전화에서도 같은 속도가 나온다고 읽을 숫자는 아닙니다.
여기서 모듈형 구조의 장점은 필요한 일부터 작게 시작할 수 있다는 데 있습니다. 메모 검색이 필요한데 사진·소리까지 한꺼번에 넣으면 초기 색인을 만드는 시간과 검증할 대상도 늘어납니다. 자주 다시 찾는 자료부터 넣고, 검색이 실제로 도움이 되는지 본 뒤 범위를 넓히는 편이 모델의 장점을 확인하기 쉽습니다. 모든 파일을 읽을 수 있다는 가능성과 모든 파일을 한꺼번에 읽힐 이유는 각각 따져볼 일입니다.
벡터가 작아지면 놓치는 자료도 함께 봐야 합니다
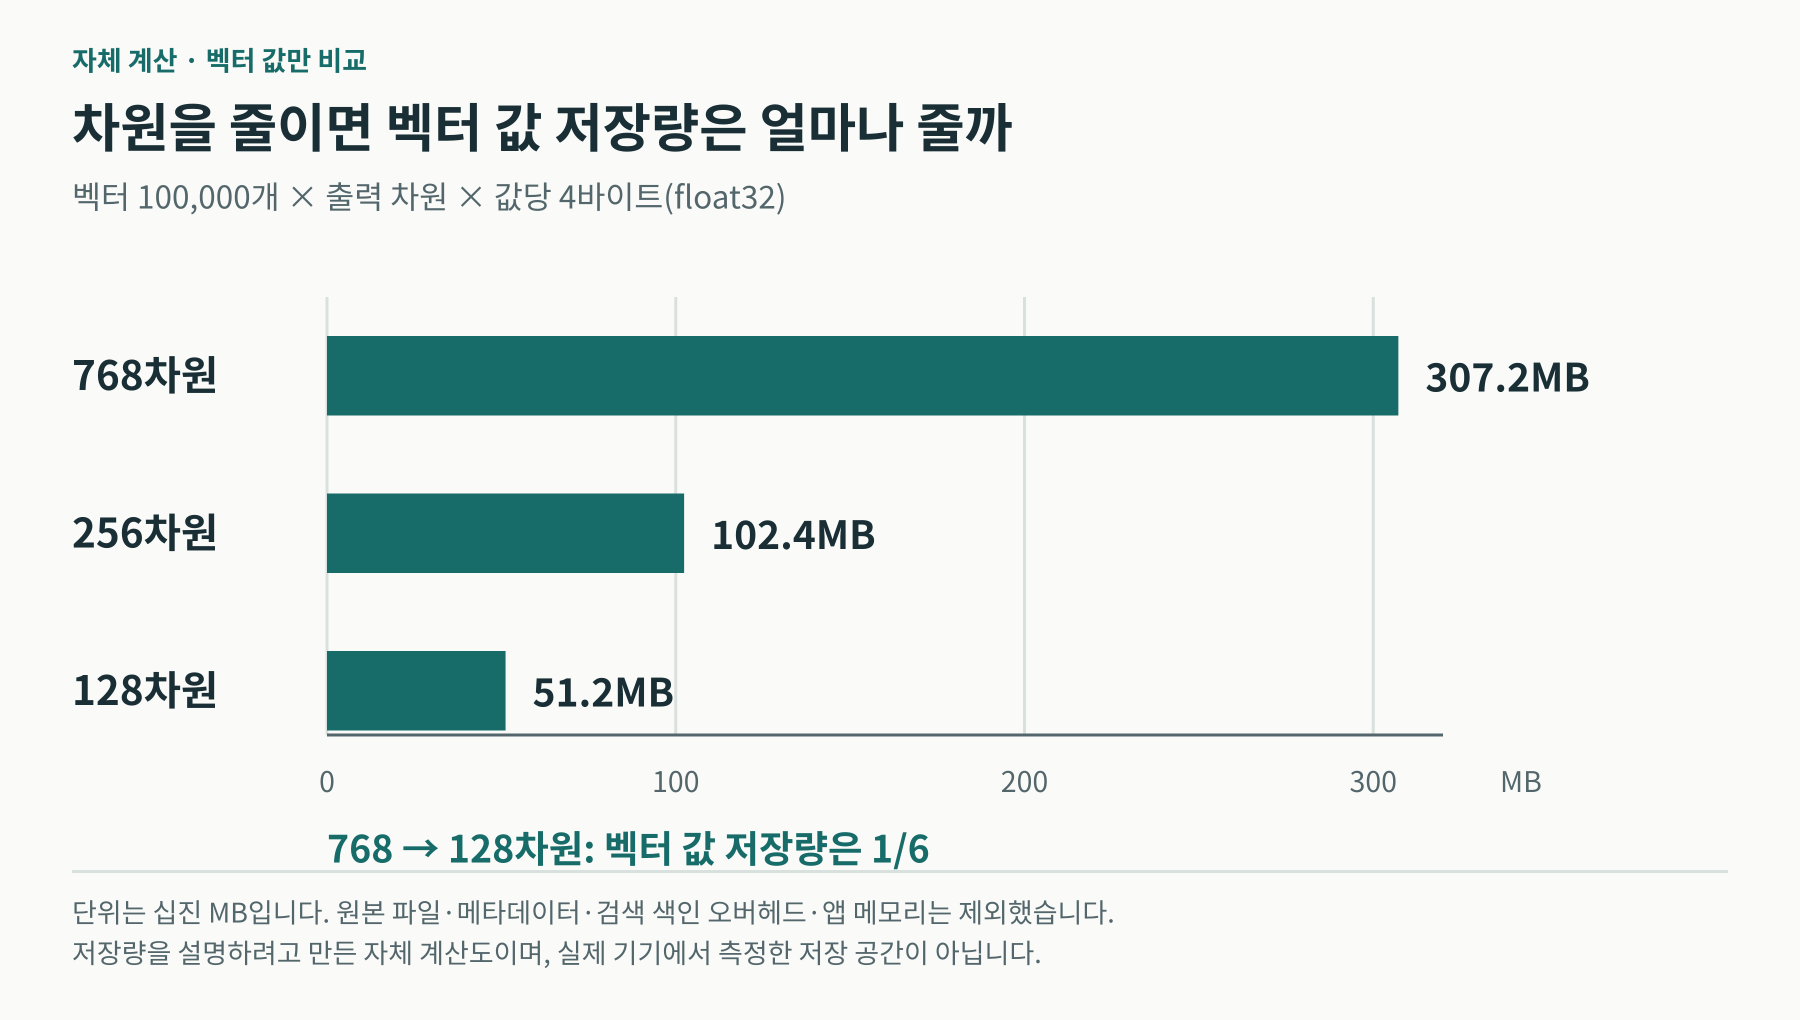
자료가 쌓이면 모델을 실행하는 메모리와 별도로 검색용 벡터를 저장할 공간이 필요합니다. Google의 2026년 10월 6일 발표에 나온 “최대 6배” 절감은 출력 벡터를 768차원에서 128차원으로 줄이는 비교입니다. Google The Keyword 자료 1 숫자 하나의 저장 크기가 같다면 벡터 값이 차지하는 공간은 6분의 1이 됩니다. 원본 영상, 파일 정보, 검색 색인의 부가 구조까지 그 비율로 줄어드는 것은 아닙니다.
조건을 정해 직접 계산해보겠습니다. 벡터 10만 개를 값당 4바이트인 float32로 저장한다고 가정하면, 768차원은 307.2MB, 256차원은 102.4MB, 128차원은 51.2MB입니다. 이 계산의 단위는 십진 MB이며 벡터 값만 셌습니다. 자료 하나를 여러 구간으로 나누면 벡터도 여러 개가 될 수 있으므로, 이 숫자를 사진이나 동영상 10만 개의 실제 저장량으로 읽어서는 안 됩니다.
줄인 벡터가 무엇을 놓치는지도 중요합니다. 2026년 10월 7일 확인한 Google 모델 카드에서 MMEB v2 종합 점수는 768차원 59.01, 256차원 56.24, 128차원 45.65입니다. Google AI for Developers 자료 2 사진과 영상을 함께 찾을 때 가장 작은 설정부터 고르면 절약한 공간만큼 검색이 마음에 들지 않을 수 있습니다. 저장 공간이 부족하다면 256차원부터 비교하고, 더 줄일 때는 찾으려던 자료가 검색 결과에서 밀려나지 않는지 확인할 만합니다.
| 출력 차원 | 벡터 10만 개의 값 저장량 | MMEB v2 종합 점수 |
|---|---|---|
| 768 | 307.2MB | 59.01 |
| 256 | 102.4MB | 56.24 |
| 128 | 51.2MB | 45.65 |
이 평가는 모델 카드의 full-precision 체크포인트를 사용한 결과입니다. Google AI for Developers 자료 2 앞서 소개한 휴대전화의 양자화 RAM 수치와는 조건이 다릅니다. 모델을 작게 실행하는 선택과 출력 벡터를 짧게 저장하는 선택을 나누어 보면, 무엇을 줄였고 무엇을 다시 시험해야 하는지 선명해집니다.
한국어로 기억한 장면을 정말 찾는지가 다음 질문입니다
Google이 2026년 10월 6일 공개한 MTEB Code 점수는 이전 모델 68.76에서 EmbeddingGemma 2의 78.68로 9.92점 높아졌습니다. Google The Keyword 자료 1 반면 2026년 10월 7일 확인한 모델 카드의 다국어 텍스트 평균은 61.15에서 61.36으로 바뀌었습니다. Google AI for Developers 자료 2 검색 성능이 모든 언어와 자료에서 같은 폭으로 좋아졌다고 읽기보다, 어떤 용도에서 개선이 두드러지는지 살펴볼 비교입니다.
개인 검색에서는 평가표의 평균보다 내가 기억하는 표현이 얼마나 통하는지가 더 가깝게 다가옵니다. “우산을 든 사람”과 “비 피하던 골목”은 같은 사진을 가리킬 수 있지만 검색어의 초점이 다릅니다. 짧은 한국어 메모, 약어가 섞인 코드 설명, 배경 소음이 있는 녹음도 각각 조건이 다릅니다. 익숙한 자료를 여러 말로 찾아보면 정확한 단어를 알아야만 되는 검색인지, 내용으로도 닿는 검색인지 구별할 수 있습니다.
직접 확인할 출발점은 이미 공개됐습니다. Google의 2026년 10월 6일 AI Edge 안내에서 Instant Media Search는 미디어와 검색어의 임베딩을 기기 안에서 계산하고 미디어 벡터를 로컬 SQLite 데이터베이스에 저장합니다. Video Moments Finder는 로컬 영상에서 질문과 가까운 장면의 시점을 찾는 데모입니다. Google Developers Blog 자료 4 모델의 설명을 읽는 데서 한 걸음 더 나아가, 어떤 자료를 넣고 무엇을 찾아볼지 정할 수 있습니다.
비교한다면 정답이 있는 검색어와 정답이 없는 검색어를 같이 준비하는 편이 좋겠습니다. 원하는 파일이 상위 결과에 들어오는지, 비슷한 장면들 사이에서 엉뚱한 파일이 앞서는지, 해당 자료가 없을 때도 닮은 후보만 계속 내놓는지 보는 것입니다. 파일명 검색으로 바로 찾을 수 있는 자료도 함께 넣어두면 새 방식이 보태는 도움이 어디에 있는지 드러납니다. 이 글에서는 모델을 실행해 측정하지 않았으며, 이 비교는 실제 쓸모를 확인하기 위한 제안입니다.
찾아준 파일을 바로 열 수 있는 작은 검색부터
로컬 검색에서 마지막으로 확인할 것은 자료가 이동하는 범위입니다. 임베딩 계산을 기기 안에서 마쳐도 검색 결과를 요약하려고 외부 모델에 보내면 그 단계에서 자료가 밖으로 나갑니다. 검색 색인이 클라우드 백업에 포함되는지, 선택한 폴더 밖의 파일도 읽는지, 원본을 지웠을 때 검색 색인에도 반영되는지까지 살펴봐야 합니다. 모델의 처리 위치가 앱 전체의 개인정보 처리 방식을 대신 설명해주지는 않습니다.
그 조건을 분명히 할 수 있다면, 이 모델을 써볼 이유는 꽤 구체적입니다. 정리할 때 잘 붙여놓은 이름에만 기대지 않고, 나중에 기억나는 내용으로 자료에 다시 닿을 수 있습니다. 검색 결과가 어느 파일의 어느 부분인지 보여주면 사용자는 후보를 확인하고 다음 일을 이어갈 수 있습니다. 처음 사진을 모은 목적이 사진 앱 안에 오래 보관하는 데만 있었던 것은 아니니까요.
EmbeddingGemma 2는 개발자가 앱에 가져다 쓰고 조정할 수 있도록 Apache 2.0으로 공개됐습니다. Google AI for Developers 자료 3 이제 기대하는 변화는 자료를 다시 찾는 순간에 있습니다. “그 장면이 어디 있었더라”라고 적었을 때, 내 기기 안의 원본이 곧바로 열리는 것. 인터넷 연결이나 업로드를 기다리지 않아도 그 정도의 검색이 믿을 만해진다면, 모아둔 자료를 쓰는 방식도 조금 달라질 수 있습니다.
참고한 자료
- Google The Keyword · EmbeddingGemma 2: an open, lightweight multimodal embedding model · 2026-10-06
- Google AI for Developers · EmbeddingGemma 2 model card · 2026-10-07 확인
- Google AI for Developers · EmbeddingGemma · 2026-10-07 확인
- Google Developers Blog · Bring multimodal semantic search to the edge with EmbeddingGemma 2 · 2026-10-06
- Google Developers Blog · EmbeddingGemma 2: The Developer Guide · 2026-10-06